Rust ist kein C++ mit anderer Syntax
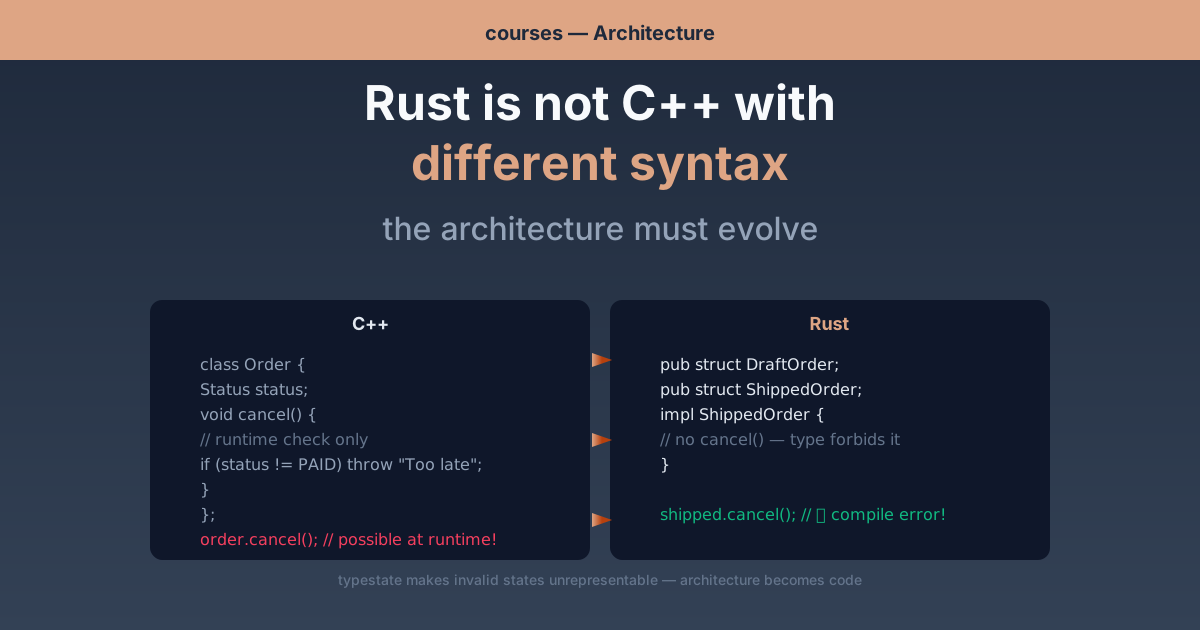
Wer jahrzehntelang C++ geschrieben hat, hat ein präzises mentales Modell im Kopf: RAII räumt Speicher auf, virtuelle Methoden kapseln Verhalten, Exceptions transportieren Fehler. Wer jetzt „mal schnell Rust" ausprobiert, füttert dieses Modell mit neuer Syntax — und scheitert. Nicht weil Rust schwerer wäre, sondern weil es die drei Säulen des C++-Denkens durch etwas anderes ersetzt. Wer das übergeht, schreibt „C++ mit anderer Syntax" — unsicher, unidiomatisch und voller Kämpfe mit dem Compiler.
Die Falle der wörtlichen Übersetzung
Die Forschung hat diese Erfahrung inzwischen gemessen. Das Papier „C-to-Rust Fallacy: Automatic Refactoring ≠ Memory Safety" (arXiv 2609.25682) zeigte: wörtliche Übersetzung von C/C++ nach Rust hält die Architektur des Ausgangscodes — und damit oft auch dessen Bugs. Das Ergebnis ist memory-safe, aber nicht besser: Wer die falsche Struktur 1:1 überträgt, hat nur die Fehlerklasse gewechselt.
Dazu passt der Befund aus dem TRACTOR-Benchmark (arXiv 2609.25121): Die Qualität einer Übersetzung hängt nicht vom Werkzeug, sondern vom Abbild der Struktur ab. Ein guter Übersetzer ersetzt nicht Zeilen, sondern Denkmuster. Das beginnt bei den drei Säulen.
Übersetzen ist ein Architekturprojekt, kein Syntaxprojekt
Eine gelungene Migration ersetzt das Design des C++-Codes durch das Design von Rust — nicht die Schlüsselwörter. Wer nur Keywords ersetzt, bekommt compilierbares Rust, das sich wie C++ anfühlt und dessen Fehler mitnimmt.
RAII ist nicht Ownership
C++ erzwingt Ressourcenfreigabe zur Laufzeit des Konstruktors/Destruktors.
std::unique_ptr ist die bekannteste Abkürzung. Rust macht daraus eine
Frage des Typsystems: Ownership bestimmt, wer eine Ressource besitzt, und
der Borrow Checker beweist zur Compile-Zeit, dass keine Referenz länger lebt
als ihr Besitzer.
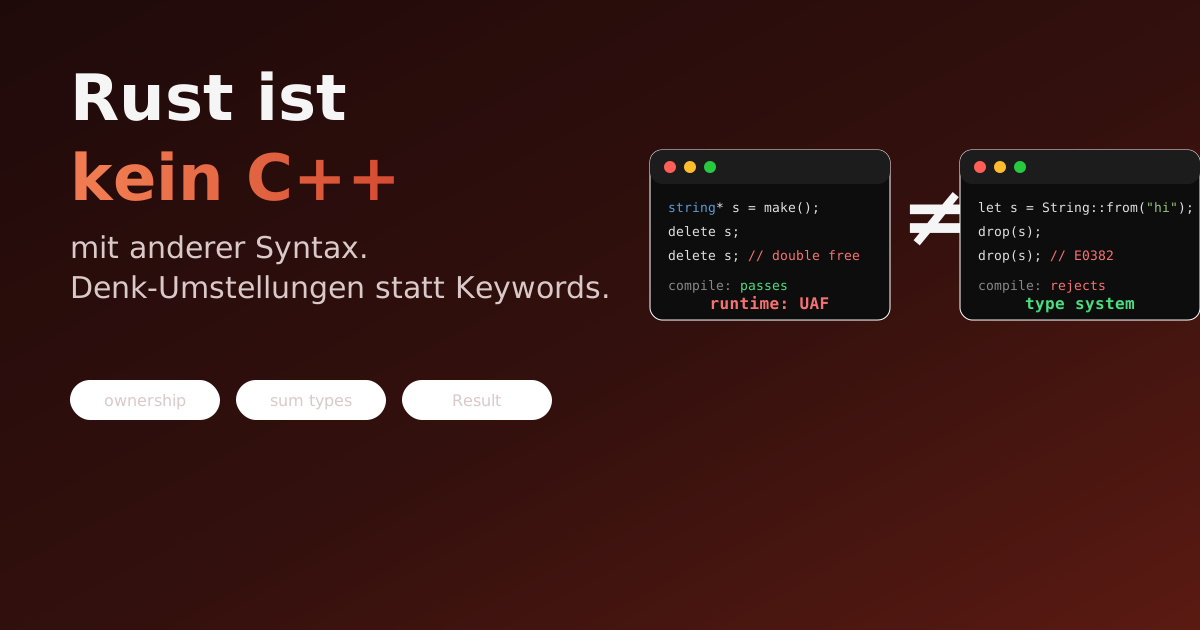
// C++: kompiliert — Use-after-Free passiert zur Laufzeit
std::string* make() { return new std::string("hallo"); }
void use() {
    std::string* s = make();
    delete s;
    delete s;   // double free — niemand meckert zur Compile-Zeit
}
// Rust: Der Compiler lehnt das Programm ab, bevor es existiert
fn use_it() {
    let s = String::from("hallo");   // Ownership liegt bei s
    drop(s);
    drop(s); // E0507/E0382: "value used here after move" — Compile-Fehler
}
Der Unterschied ist fundamental: C++ verlässt sich auf Disziplin (oder Laufzeit-Tools wie AddressSanitizer), Rust auf Beweise im Typsystem. Ein Use-after-Free ist in Rust kein Laufzeit-Bug mehr, sondern gar kein Programm.
Klassen sind keine Sum Types
C++ modelliert Varianten über Vererbung: eine Basisklasse mit virtual
Methoden, Unterklassen mit Spezialverhalten. Das öffnet eine unkontrollierte
Menge: Jede neue Operation muss wissen, welche Unterklassen es gibt — und
Vergessen ist ein stiller Laufzeitfehler.
// C++: neue Unterklasse, und Switch/if-Ketten vergessen sie still
class DocumentOp { public: virtual void apply() = 0; };
class InsertOp : public DocumentOp { public: void apply() override {} };
// Rust: enum + match — der Compiler erzwingt Vollständigkeit
enum DocumentOp { Insert { pos: usize, text: String }, Delete { pos: usize, len: usize } }
fn apply(op: &DocumentOp) {
    match op {           // fehlt ein Arm? Compile-Fehler.
        DocumentOp::Insert { .. } => {}
        DocumentOp::Delete { .. } => {}
    }
}
Der Sum Type (enum) schließt die Variantenmenge: Jeder match muss alle
Fälle behandeln, sonst kompiliert das Programm nicht. Was in C++ ein
Testprotokoll braucht, erzwingt Rust zur Compile-Zeit.
Exceptions sind keine Fehlerwerte
throw/catch versteckt Kontrollfluss: Eine Funktion kann an beliebiger
Stelle aufhören, und der Aufrufer erfährt es nur, wenn er an allen
Stellen fängt. Rust macht Fehler zu Werten in Result<T, E> — der
Kontrollfluss bleibt sichtbar.
// Rust: Fehler sind Werte, jede Abzweigung sichtbar
fn parse(input: &str) -> Result<u32, String> {
    input.parse().map_err(|_| "keine Zahl".to_string())
}
fn run(input: &str) -> Result<(), String> {
    let n = parse(input)?;   // ? gibt den Fehler explizit weiter
    println!("{}", n);
    Ok(())
}
Ob man mag, dass ? das catch-Climbing ersetzt: Der wesentliche Punkt ist,
dass kein Pfad versteckt ist. Der Typ sagt „diese Funktion kann
fehlschlagen", und der Aufrufer muss damit umgehen.
unsafe: das Tor, das C++ fehlt
Am wichtigsten ist vielleicht das, was C++ gar nicht hat: eine Grenze.
In C++ ist die komplette Sprache ein einziges unsichtbares unsafe-Block —
Zeigerarithmetik, Aliasing, Undefined Behavior sind überall erlaubt. Rust
konzentriert diese Mittel hinter einem sichtbaren Schlüsselwort.
unsafeist ein Tor, kein Werkzeug. (Modul 25, Lektion 4)
Wer nach Rust migriert, sollte unsafe nicht wie reinterpret_cast
verteilen, sondern wie eine bewachte Tür behandeln: benannte Invariante,
Test, der bricht, wenn sie verletzt wird — und Verifikation mit Miri oder
Kani an der Naht (10.1145/3832783.3834503).
Übersetzen heißt Architektur ändern
Daraus folgt die Migrationsstrategie — nicht Big Bang, sondern Ship of Theseus (10.1145/3843775.3844544): Komponente für Komponente ersetzen, jede Naht über FFI am Leben lassen, das System bleibt lieferbar. Die Checkliste ist kurz:
- Sum Types statt virtueller Hierarchien?
- Ownership explizit — kein
Rc<RefCell>-Reflex? Result, kein Panic auf Eingabedaten?- Char-Indizes (Unicode), nie Byte-
len()? - Tests: Round-Trip + Fehlerpfade je Einheit?
unsafe: begründet, benannt, getestet?
Weiterlesen
Diese Artikel ergänzen das Thema:
- „Vom C zu Rust: Wenn die Übersetzung bewiesen wird" — wie vergleichende symbolische Ausführung Äquivalenz beweist
- „Rusts Sicherheitsmodell ist keine Meinung — es ist bewiesen" — warum das Typsystem ein Beweissystem ist
Ins Thema einsteigen
- Modul 25: C++ zu Rust — Sum Types, Ownership-Umzug, cxx/bindgen und Ship-of-Theseus im Detail
- Modul 3: Ownership, Borrowing & Slices — warum Use-after-Free in Rust unmöglich ist
- Modul 20: Unsafe Code — wo
unsafenötig ist und wie man es als Tor kapselt
Bereit, den Mentalmodell-Umzug zu machen? In unserem Rust-Kurs lernst du Ownership, Sum Types und Unsafe interaktiv — mit Playground, Quiz und spaced repetition, damit es hängen bleibt.