Vom C zu Rust: Wenn die Übersetzung bewiesen wird
Millionen Zeilen C-Code laufen in produktiven Systemen — Betriebssysteme, Treiber, Kryptobibliotheken. C ist mächtig, aber nicht speichersicher: Use-after-Free, Pufferüberläufe und Double-Frees sind die häufigsten Sicherheitslücken der letzten Jahrzehnte. Rust verspricht Abhilfe — aber wie übersetzt man Millionen Zeilen Legacy-Code, ohne ihn dabei kaputtzumachen?
Das Dilemma der automatischen Übersetzung
Naive Übersetzung von C nach Rust scheitert an einem grundlegenden Problem:
C und Rust haben unterschiedliche Speichermodelle. C erlaubt beliebige
Zeiger-Arithmetik, manuelle Speicherverwaltung und implizite Konvertierungen.
Rust verbietet all das zur Compile-Zeit. Eine direkte 1:1-Übersetzung
produziert entweder Code, der sich nicht kompilieren lässt, oder Code, der
unsafe so oft verwendet, dass der Sicherheitsgewinn null ist.
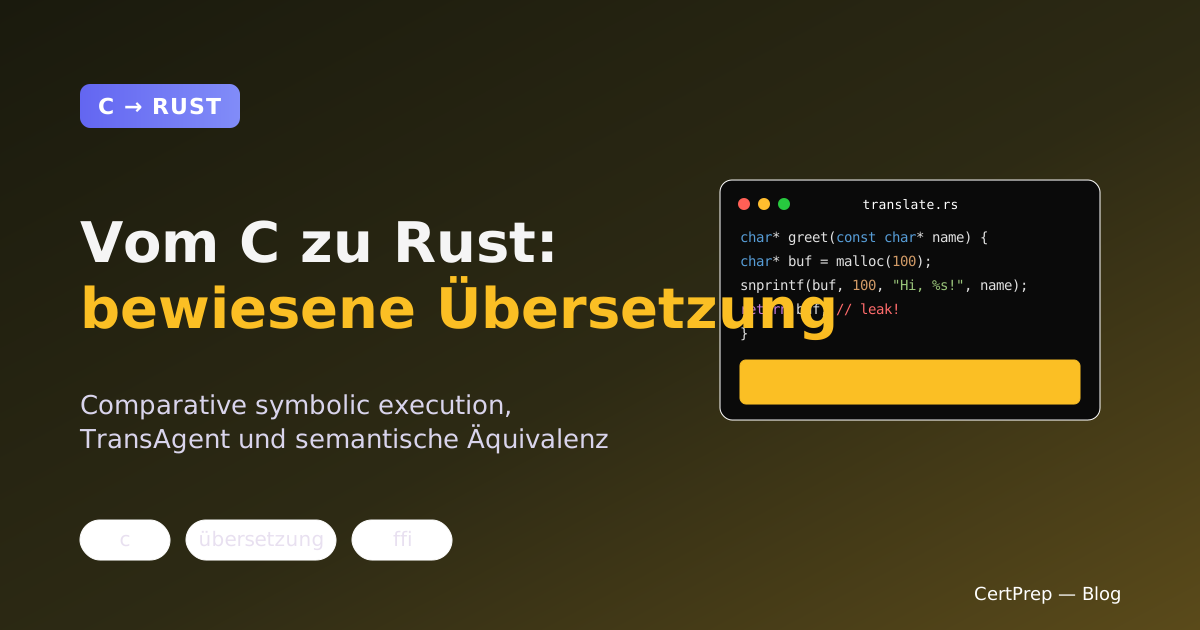
// C: funktioniert, aber unsicher
char* greet(const char* name) {
    char* buf = malloc(100);
    snprintf(buf, 100, "Hallo, %s!", name);
    return buf;  // Caller muss free() aufrufen — vergisst er es, Speicherleck
}
// Rust: sicher, aber andere Semantik
fn greet(name: &str) -> String {
    format!("Hallo, {}!", name)
    // Kein free() nötig — Ownership erledigt das
}
Die Übersetzung funktioniert, aber die Semantik hat sich geändert: Statt
eines rohen Puffers, den der Caller freigeben muss, gibt es ein String-Objekt
mit automatischer Speicherverwaltung. Ist das dasselbe Programm? Nicht
exakt — aber es ist äquivalent in dem Sinne, dass die beobachtbaren
Effekte identisch sind.
Finding a Crab in the C: Vergleichende symbolische Ausführung
Die Studie „Finding a Crab in the C" (2026) löst genau dieses Problem. Ihr Werkzeug cozy nutzt vergleichende symbolische Ausführung (comparative symbolic execution), um die semantische Äquivalenz zwischen C-Code und Rust-Übersetzung zu beweisen — nicht zu vermuten, sondern zu beweisen.
Die Idee: cozy führt beide Versionen — das Original in C und die Übersetzung in Rust — parallel aus und prüft für jeden Eingabepfad, ob die beobachtbaren Effekte identisch sind. Wenn cozy keinen Unterschied findet, gilt die Übersetzung als assured — garantiert äquivalent.
Warum „assured“ besser als „getestet“ ist
Tests prüfen eine endliche Menge von Eingaben. Symbolische Ausführung prüft alle Eingabepfade, die das Programm nehmen kann. Ein Test kann einen Fehler übersehen; vergleichende symbolische Ausführung — wenn sie abschließt — schließt ihn aus. Das ist der Unterschied zwischen „wahrscheinlich richtig" und bewiesen äquivalent.
TransAgent: LLM-gestützte Übersetzung mit Ausrichtungs-Feedback
Während cozy auf formaler Äquivalenz setzt, verfolgt TransAgent (2024) einen ergänzenden Ansatz: LLM-gestützte Übersetzung mit feinkörniger Ausrichtung an der Ausführung (fine-grained execution alignment). Das Sprachmodell generiert eine erste Übersetzung, dann werden Original und Übersetzung ausgeführt und die Laufzeiteffekte verglichen. Abweichungen werden dem Modell als Feedback zurückgemeldet, das in einer nächsten Iteration korrigiert wird.
Das ist dasselbe Prinzip wie bei TreeCoder: Constraint-Erfüllung während der Generierung, nicht nachträglich. Die „Constraints" sind hier die beobachtbaren Effekte des Originalprogramms.
Warum C-to-Rust sicherer ist als C-behalten
Die Studie argumentiert, dass die Übersetzung nach Rust nicht nur ein Sprachwechsel ist, sondern eine Sicherheitsreparatur. C-Code, der in Rust übersetzt wurde, verliert ganze Fehlerklassen:
- Use-after-Free — in Rust unmöglich (Ownership-Modell)
- Double-Free — in Rust unmöglich (Move-Semantik)
- Pufferüberlauf — in Rust zur Compile-Zeit abgefangen (Bounds-Checking)
- Data Races — in Rust unmöglich (Borrow-Checker)
// Dieselbe Funktion in Rust — die Fehlerklasse existiert nicht mehr
fn greet(name: &str) -> String {
    format!("Hallo, {}!", name)
}
// Kein malloc, kein free, kein Puffer, kein Overflow.
// Der Compiler beweist: sicher.
Was das für die Praxis bedeutet
Die automatische C-to-Rust-Übersetzung ist noch nicht perfekt. cozy arbeitet
an Funktionen, nicht an ganzen Systemen, und die Übersetzung erfordert
manuelle Überprüfung der unsafe-Blöcke, die für FFI-Grenzen notwendig
sind. Aber die Richtung ist klar:
- Legacy-Code muss nicht für immer unsicher bleiben. Werkzeuge wie cozy machen es möglich, C-Code schrittweise nach Rust zu portieren — mit Beweisen, nicht mit Hoffnung.
- FFI ist die Brücke, nicht das Ende. Rust kann C-Bibliotheken über
extern "C"aufrufen. Man kann sicher neu schreiben und das Alte schrittweise ersetzen. - Semantische Äquivalenz ist überprüfbar. Vergleichende symbolische Ausführung macht „dasselbe Programm" zu einer beweisbaren Eigenschaft, nicht einer Vermutung.
Der Unterschied zwischen Übersetzung und Transformation
Eine Übersetzung bewahrt die Semantik. Eine Transformation verbessert sie. cozy macht beides: es übersetzt C nach Rust und transformiert dabei unsichere Muster in sichere. Das Ergebnis ist nicht dasselbe Programm in einer anderen Sprache — es ist ein besseres Programm mit bewiesener Äquivalenz.
Weiterlesen
Diese Artikel ergänzen das Thema:
- „Rusts Sicherheitsmodell ist keine Meinung — es ist bewiesen" — warum Rusts Typsystem ein Beweissystem ist
- „KI schreibt Code — aber ist er richtig?" — wie Constraints zur Generierungszeit die Qualität verbessern
Ins Thema einsteigen
- Modul 21: Foreign Functions —
extern "C", CString und die Brücke zwischen Rust und Legacy-Code - Modul 3: Ownership, Borrowing & Slices — warum Use-after-Free in Rust unmöglich ist
- Modul 20: Unsafe Code — wo
unsafenotwendig ist und wie man es sicher kapselt
Bereit, es selbst zu versuchen? In unserem Rust-Kurs lernst du FFI, Ownership und Unsafe interaktiv — mit Playground, Quiz und spaced repetition, damit es hängen bleibt.