Fuzzing Rust: Wenn LLMs den Compiler testen und unsafe Code bricht
Fuzzing ist eine der mächtigsten Methoden, um Bugs in Software zu finden: man generiert zufällige Eingaben und sieht, ob das Programm abstürzt. Aber Rust stellt Fuzzer vor eine besondere Herausforderung — und die Forschung hat 2026 überraschende Antworten geliefert.
ClozeMaster: LLMs fuzzen den Rust-Compiler
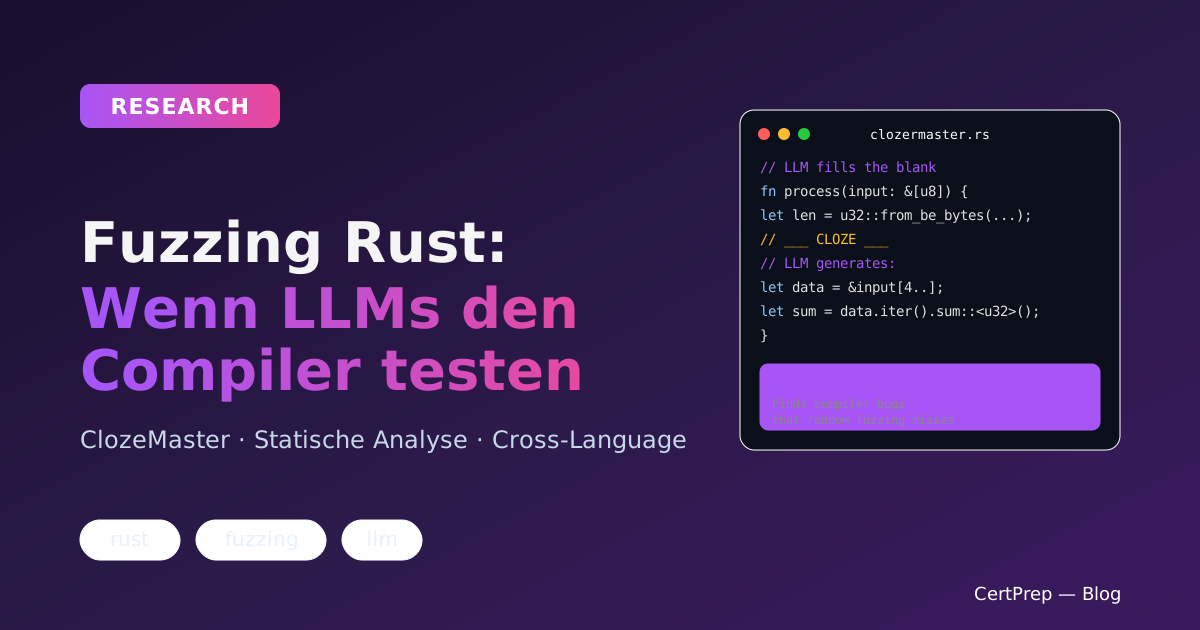
ClozeMaster (2026) nutzt große Sprachmodelle (LLMs), um den Rust-Compiler selbst zu testen. Die Idee ist genial: anstatt zufällige Programme zu generieren, nimmt ClozeMaster echte Rust-Programme, maskiert Teile davon (Lücken wie in einem Cloze-Test) und lässt ein LLM die Lücken ausfüllen. Das LLM erzeugt so gültige, aber ungewöhnliche Rust-Programme, die ein zufallsbasierter Fuzzer nie gefunden hätte.
Warum ist das wichtig? Der Rust-Compiler ist das Fundament des Sicherheitsmodells. Wenn der Compiler einen Fehler hat, kann er unsicheren Code als sicher akzeptieren. ClozeMaster findet Compiler-Bugs, die traditionelles Fuzzing verpasst.
// ClozeMaster-Methode: echte Programme mit Lücken
fn process(input: &[u8]) -> Result<u32, &'static str> {
    if input.len() < 4 {
        return Err("too short");
    }
    let len = u32::from_be_bytes([input[0], input[1], input[2], input[3]]);
    if len as usize > input.len() - 4 {
        return Err("invalid length");
    }
    // ClozeMaster maskiert z.B. diese Zeile und lässt das LLM ausfüllen:
    // let data = &input[4..4 + len as usize];
    // let checksum = data.iter().fold(0u32, |acc, &b| acc.wrapping_add(b as u32));
    Ok(0)
}
Das LLM füllt die maskierte Zeile aus — manchmal korrekt, manchmal mit subtilen Fehlern, die den Compiler zum Absturz bringen oder Panics auslösen, die ein menschlicher Tester nie gefunden hätte.
Cloze-Test-Fuzzing vs. traditionelles Fuzzing
Traditionelle Fuzzer (wie cargo-fuzz oder AFL) generieren Eingaben durch
Mutation bestehender Eingaben. Sie finden Edge Cases, aber sie generieren
selten syntaktisch gültige, semantisch interessante Programme. ClozeMaster
geht den umgekehrten Weg: es startet mit echten, gültigen Programmen und
nutzt das LLM, um gezielte Variationen zu erzeugen. Das LLM "versteht"
Rust-Syntax und -Semantik und erzeugt Programme, die an der Grenze zwischen
gültig und ungültig liegen — genau dort, wo Compiler-Bugs lauern.
False Positives in der statischen Analyse
Statische Analysetools wie Rudra und MirChecker sind wichtig, um
Speichersicherheit in Rust zu gewährleisten — besonders für unsafe-Code.
Aber sie haben ein Problem: hohe False-Positive-Raten. Jeder falsche
Alarm erodiert das Vertrauen der Entwickler, erhöht den manuellen Prüfaufwand
und kann echte Bugs verschleiern.
Mitigating False Positives in Static Memory Safety Analysis of Rust Programs via Reinforcement Learning (2026) stellt einen neuen Ansatz vor: ein Reinforcement-Learning-Modell, das automatisch zwischen echten Bugs und falschen Alarmen unterscheidet. Das RL-Modell lernt aus den Entscheidungen von Entwicklern, welche Warnungen relevant sind und welche ignoriert werden können.
// Typischer False Positive: MirChecker warnt vor möglichem Overflow
fn safe_add(a: u32, b: u32) -> u32 {
    // MirChecker: "möglicher arithmetischer Overflow"
    // Aber: a und b werden vom Aufrufer auf < 2^16 begrenzt
    a + b  // In der Praxis sicher, aber der Analyzer kann das nicht wissen
}

// RL-Modell klassifiziert: False Positive (aufgrund von Kontext)
// → Warnung wird unterdrückt, Entwickler wird nicht gestört
Das RL-Modell reduziert False Positives, ohne echte Bugs zu übersehen. Das macht statische Analyse in der Praxis nutzbar — denn ein Tool, das 90% False Positives liefert, wird von Entwicklern ignoriert.
Die Programmiersprache beeinflusst Fuzzing-Effektivität
Does Programming Language Matter? An Empirical Study of Fuzzing Bug Detection (2026) ist eine groß angelegte Cross-Language-Analyse, die eine überraschende Frage stellt: Ist Fuzzing in einer Sprache effektiver als in einer anderen?
Die Studie integrierte Fuzzing in CI-Workflows (Continuous Fuzzing) und verglich die Bug-Erkennungsrate über verschiedene Sprachen hinweg. Die Ergebnisse:
- Typsichere Sprachen (wie Rust) finden durch Fuzzing tendenziell weniger Speicherfehler — weil der Compiler viele bereits verhindert
- Aber: Fuzzing findet in Rust eher Logikfehler, Panic-Bedingungen und Edge Cases, die der Typsystem nicht abfängt
- Sprachen ohne Speichersicherheit (wie C/C++) profitieren massiv von Fuzzing, weil der Compiler viele Fehler nicht verhindert
Für Rust-Entwickler bedeutet das: Fuzzing ist kein Ersatz für den Borrow Checker — es ist eine ergänzende Methode, die eine andere Fehlerklasse findet.
Was das für die Praxis bedeutet
Die Fuzzing-Landschaft für Rust hat 2026 drei wichtige Fortschritte gemacht:
| Werkzeug | Ansatz | Findet |
|---|---|---|
| cargo-fuzz | Traditionelles Fuzzing | Panics, Assert-Fehler |
| ClozeMaster | LLM-gestütztes Cloze-Fuzzing | Compiler-Bugs |
| RL-Klassifikator | False-Positive-Reduktion | Echte Bugs (keine falschen Alarme) |
Für Rust-Entwickler: nutzt cargo-fuzz für eure Bibliotheken, vertraut
nicht blind auf statische Analyse (sondern nutzt RL-Klassifikatoren), und
denkt dran: Fuzzing findet in Rust andere Fehler als in C — aber es findet
sie.
Ins Thema einsteigen
- Modul 20: Unsafe Rust — unsafe-Code verstehen und sicher einsetzen
- Modul 15: Testing — Testen in Rust, inklusive Property-Based Testing
- Modul 8: Traits und Generics — Wie Rusts Typsystem Sicherheit zur Compile-Zeit erzwingt
Weiterführende Artikel:
- Rusts Sicherheitsmodell ist keine Meinung — es ist bewiesen — Neuro-symbolische Verifikation und AutoVerus
- Vom C zu Rust: Wenn die Übersetzung bewiesen wird — Wie C-Code automatisch nach Rust übersetzt wird